VLN 任务与评测:数据集、动作空间与评价指标
视觉语言导航的评价取决于任务如何定义:沿指定路线到达、寻找描述中的物体、根据对话继续行动,分别需要不同的输入、输出与成功条件。本文梳理代表性数据集和动作空间,推导终点成功、路径效率与路线忠实度指标,并用可复算的轨迹例子解释这些指标之间的差异。
“先经过靠窗的餐桌,再穿过走廊,在书架旁停下。”如果智能体绕开餐桌,直接走到书架,它完成了多少任务?终点正确,运动也可能更高效,但指定的路线没有完整执行。再把指令换成“找到客厅窗边的那盏落地灯”,评价还要检查智能体是否认对了物体。
这两种情形说明,模型结构之前需要先确定任务协议:语言提供什么信息,策略能看到什么,动作如何执行,评测器依据什么判定成功。系列综述给出了研究版图,本篇进一步建立阅读数据集、模型实验和评测代码所需的共同定义。
一、任务定义与信息边界
1.1 语言条件下的闭环决策
设语言输入为 ,时刻 的观测为 ,此前执行的动作为 。一个通用的导航策略可以写成
表示参数为 的动作分布。观测可以包含 RGB、深度、朝向、局部候选等,但具体有哪些内容,必须由任务协议限定。策略执行一个动作后,环境产生新的观测;动作序列因此依赖实际经历,无法仅凭一句指令提前固定下来。
令环境状态为 ,这一过程可抽象为
是状态转移机制, 是观测机制。状态可能包括完整布局与机器人位姿,策略只取得其中允许观测的部分。这组表达式既能描述导航图上的移动,也能描述连续空间执行;差别在于状态、观测与动作的具体定义。
完成一次回合后,策略输出执行轨迹 和终止结果。目标指代任务还需要物体预测 ;交互任务可能允许追加求助动作,并使语言输入随对话更新。
1.2 策略输入、训练监督与评测真值
一个数据文件可能同时保存完整参考路线、终点、物体标注和相机位姿。这些字段具有不同用途,不能因为它们存在于文件中,就全部作为测试策略的输入。
| 信息 | 训练或评测中的用途 | 测试策略的使用条件 |
|---|---|---|
| 指令、当前视觉 | 理解任务与当前环境 | 按任务协议提供 |
| 当前合法候选、相对方向 | 构造动作集合 | 图导航可提供;其他设定需自行预测或构建 |
| 参考路线、专家动作 | 监督学习、路线对齐评分 | 不能作为自主导航的真值提示 |
| 目标位置、完整距离表 | 生成教师动作、计算误差和最短路 | 评测器可用,不自动向策略开放 |
| 物体候选框 | 候选级视觉指代 | 取决于基准是否提供;不等于告知正确目标 |
由此还要区分三个对象:场景资源提供环境,模拟器提供交互,数据集提供任务实例与标注。 例如 Matterport3D、Matterport3D Simulator 与 R2R 分别承担这三种职责。换模拟器、增加深度输入或提供更准确的候选位置,都可能改变模型需要解决的问题。R2R 论文
二、数据集与任务能力
2.1 路线跟随:R2R、R4R 与 RxR
R2R(Room-to-Room)将室内扫描环境中的路线与自然语言对应起来。它的典型任务是从指定起点出发,依据逐步描述经过地标,并在目标附近停止。原数据包含 7,189 条路线,每条有三份描述,共 21,567 条指令;路线来自满足长度限制的最短路径采样。R2R
这一构造使“跟随参考路线”与“高效到达终点”经常具有一致方向,但两者在定义上仍有区别。如果模型只依赖终点词语或路线分布,也可能取得一定成功;成功率本身无法说明它使用了多少中间指令。
R4R(Room-for-Room)把两条端点相近的 R2R 路线通过连接路径组合,同时拼接语言描述。组合路线可能包含折返和非最短路段,要求模型保留先后顺序与中间地标。此时,到终点的捷径可能偏离指令,评测需要考虑整条参考路线。R4R
RxR(Room-Across-Room)进一步扩展语言与标注方式,包含英语、印地语和泰卢固语,并将词语时间与标注者的相机姿态对齐。它支持研究多语言泛化,以及语言片段与沿途视觉之间的联系。时间对齐提供了“说到这里时看向哪里”的线索,并不直接等价于逐词对应的物体分割真值。RxR
三者的关系可以从研究变量理解:R2R 建立基本的指令跟随任务;R4R 强化路线忠实度;RxR 扩展语言覆盖及视觉语言对齐。它们不是可以仅凭规模大小排列的难度等级。
2.2 目标寻找:REVERIE 与 SOON
路线描述通常依赖起点和行走方向。“离开房间后右转”换一个起点就可能失去意义;“客厅窗边、沙发左侧的落地灯”则主要描述目标及其环境关系。
REVERIE要求智能体寻找起点不可见的目标物体,并完成视觉指代。评测需要区分:是否停在能观察目标的位置,以及是否选择了正确对象。对于提供候选框的设置,核心输出是正确候选;对于直接预测框的设置,还要按照规定检查框的重合度。两种设置承担的检测与定位工作量不同。REVERIE
SOON强调与起点相对独立的目标描述,使用对象属性、对象关系、所在区域及邻近区域引导探索。例如,房间线索先缩小搜索范围,对象关系再区分具体目标。其定位评价检查预测方向是否落在目标框内,因此不能直接套用另一数据集的框检测规则。SOON
目标寻找允许智能体自行选择合理路线。若语言没有规定必须经过某处,就不能仅因为它未复现某一条示范路线而认定失败。参考路线在这类任务中可能服务于训练或效率计算,其角色应与路线跟随任务分别说明。
2.3 交互式导航:CVDN 与 HANNA
CVDN采集导航者与协助者的对话。其 Navigation from Dialog History(NDH)任务使用目标提示、已有对话和当前观测,预测接下来的行动。这里主要检验理解已有对话后的导航能力;“何时主动提问、如何生成问题”还需要相应的交互任务设计。CVDN
HANNA允许智能体请求帮助,并获得语言与视觉形式的辅助信息。因此,导航能力之外,还需要分析求助时机、次数、助手信息和交互预算。拥有更多外部辅助的策略,即使成功率更高,也不能据此认定其自主导航能力更强。HANNA
2.4 街景导航:Touchdown
Touchdown使用街景全景图,研究长距离语言导航与空间描述解析。其导航任务要求到达目标节点或邻接节点;Spatial Description Resolution(SDR)则根据语言,在图像中预测被指代的位置。后者的输出是像素坐标,评价尺度也随之改变。Touchdown
街景图来自现实采集,但在图中移动仍是仿真交互。该协议没有自动包含动态行人避让、交通规则或真实底盘控制。
2.5 数据集的对照维度
| 任务或数据集 | 语言主要提供什么 | 额外输出或信息 | 评价重点 |
|---|---|---|---|
| R2R | 逐步路线描述 | 轨迹与停止 | 到达、路径效率 |
| R4R | 组合后的长路线描述 | 参考路线 | 中间地点覆盖、访问顺序 |
| RxR | 多语言路线描述 | 带时间与姿态关联的标注 | 到达、路线忠实度、多语言泛化 |
| REVERIE | 远程物体指代 | 目标物体预测 | 导航与物体接地 |
| SOON | 目标属性、关系与区域 | 目标方向预测 | 自主探索与目标定位 |
| CVDN/NDH | 目标提示与对话历史 | 历史问答 | 根据对话向目标推进 |
| HANNA | 目标及按需辅助 | 求助动作、语言与视觉帮助 | 导航成功与求助行为 |
| Touchdown | 街景路线及空间描述 | 导航轨迹或图像坐标 | 街景到达、空间描述解析 |
| VLN-CE | 连续环境中的路线指令 | 低层动作与执行轨迹 | 到达、路线质量及运动执行 |
VLN-CE 的主要变化发生在环境与动作接口,下面单独展开。表中每一行都需要配合具体版本的输入权限、划分和评测器理解。
三、动作空间与环境假设
3.1 导航图与全景候选
图导航将环境表示为加权图 :节点对应可观察位置,边表示可通行连接。在常见的全景候选接口中,动作集合可抽象为
其中 是当前节点, 是允许选择的邻接节点。策略选择一个候选后,环境把智能体移动到对应位置。
这是一种高层接口概括。原始 R2R 基线还包含转头、抬头、低头和受当前视野约束的移动;后续全景方法改变了观测和候选组织。使用同一个 R2R 数据集,不代表使用同一种动作接口。 R2R 模拟器与任务定义
已给出的连边至少提供了局部可通行性先验,节点间移动也屏蔽了沿途的低层控制过程。策略获取相邻候选,不等于已经获得整栋建筑的完整地图;这两种信息权限仍需分别记录。
3.2 连续环境中的离散控制
VLN-CE 将路线执行放入连续三维环境。其原始低层动作包括前进 、左转 、右转 和停止。位置在连续空间变化,但动作集合仍然有限。VLN-CE
图 1:动作接口示意。图中节点与轨迹为解释概念而绘制;连续值控制一栏表示通用机器人接口,不是原始 VLN-CE 的动作定义。 查看原图
与图上选择邻点相比,连续执行需要处理沿途观测、局部障碍、转向与停止。VLN-CE 的原始设定移除了预给拓扑、节点间短程代走和完美定位等强假设,但仿真的低层运动仍有自身简化,不能由“连续”直接推导出已经验证真实机器人动力学。
3.3 连续值动作与分层执行
如果策略直接输出底盘线速度和角速度,可以写成 ,其中 是线速度, 是角速度。也可以先预测路点,再由规划器和控制器执行。速度命令通常还受机体能力约束,其可取范围和执行周期都是接口定义的一部分。
| 接口 | 一次决策输出 | 局部执行由谁承担 | 必须记录的条件 |
|---|---|---|---|
| 图节点选择 | 邻接节点或 STOP | 导航图交互接口 | 候选来源、全景范围、位置权限 |
| 连续环境离散步进 | 前进、转动或 STOP | 仿真运动与碰撞机制 | 步长、转角、机体尺寸、碰撞配置 |
| 连续值运动控制 | 速度、角速度等实数 | 控制器与机体 | 单位、频率、速度限制、动力学 |
| 路点与分层执行 | 目标路点或中层动作 | 规划器与低层控制器 | 路点可达性、执行容差、失败反馈 |
步数不能跨这些接口直接比较。一次图跳转与一次 前进的空间尺度不同;连续值控制还依赖持续时间。要评价执行效率,需要进一步报告实际路程、时间与相关计算成本。
四、终点成功、路径效率与路线忠实度
4.1 距离、轨迹与符号约定
下文对单个回合使用:执行路径 、参考路径 、目标 ,以及成功距离阈值 。 表示协议规定的最短可通行距离;图任务通常使用加权最短路,连续环境则依具体评测器确定。
隔墙的两点可能直线距离很小,可通行距离却很长。自行实现指标时,替换距离函数会改变任务含义。
对于由合法相邻图移动构成的路径,其长度为
连续执行则应按协议累计实际运动轨迹长度。把稀疏日志点之间的最短距离相加,可能漏掉两次记录之间的绕行。同一地点的纯旋转在路径长度中可以贡献零,但仍消耗时间。
4.2 NE、SR 与 OSR:终点和停止行为
导航误差 Navigation Error 衡量最终位置到目标的距离:
原始 R2R 采用严格小于 的成功条件。令第 个回合的成功指示为 ,则
是评测回合数, 在条件成立时取 1,否则取 0。更换基准时,应使用它规定的阈值、边界不等号和终止条件。R2R 评价定义
Oracle Success Rate 检查轨迹是否曾经进入目标范围:
这里的 oracle 只在评价时利用目标真值。它不能作为策略运行时的自动停止器。同一阈值与轨迹集合下,;较大的差距提示智能体曾到过附近却没有正确结束,但仍需查看轨迹,才能判断是停止识别、回退还是步数耗尽导致失败。
4.3 SPL:成功与最短路效率
令 为起点到目标的最短路径长度, 为实际执行长度。Success weighted by Path Length 定义为
失败回合贡献零;成功回合再按长度效率加权。分母取最大值,使得因成功半径而提前停止、实际路程短于到精确目标的最短路时,得分仍不超过 1。该指标由导航评测建议提出。
例如,四个回合中三个成功,三条成功路径分别为对应最短路的 1、2、2 倍,那么
因此 SPL 同时混合了成功与效率,不能把它直接解释成“平均绕路比例”。它满足 。若允许起点就是目标、最短长度为零,还必须遵循评测器的退化情况约定。
SPL 的效率基准是起终点最短路。对于明确要求经过中间地点的非最短路线,这个基准与指令忠实度可能冲突。
4.4 CLS:路径覆盖与长度匹配
Coverage weighted by Length Score 使用参考路径的全部位置。首先定义覆盖得分
每个参考位置都寻找执行路径中的最近位置。距离为零时贡献 1,距离增大时贡献衰减; 在这里控制衰减尺度。PC 为软覆盖分数,不是“经过了多少比例的节点”的硬计数。
然后用覆盖程度缩放参考路径长度,得到期望长度 ,并构造长度得分:
长度项防止智能体通过大量无目的探索获得高覆盖。分子与分母均为长度,最终分数无量纲。这套定义来自 R4R 论文第 3.3 节。
CLS 中的最近点匹配没有显式要求先后顺序。因此,相同地点集合与相同长度的路径,即使访问顺序不同,也可能得到相同得分。顺序约束需要进一步引入序列对齐。
4.5 nDTW:保持顺序的轨迹对齐
Dynamic Time Warping(DTW,动态时间规整)将两条序列按顺序对齐,同时允许一个点对应另一条路径中的多个点。它从两条路径的起点开始,到两条路径的终点结束,中间不能把较晚的位置倒过来匹配到较早的位置。
令 表示参考前 个点与执行前 个点的最小累计代价:
初始化为 ,其余边界 ()。三项分别允许推进参考序列、推进执行序列或同时推进;最终 。
将其按参考点数与距离阈值归一化,再取负指数:
累计偏离越大,分数越低;完全匹配时为 1。 是参考路径的采样点数,不能换成参考路程的米数。精确递推需要 时间;仅计算分数时可以用滚动行降低存储量。nDTW 论文及算法
按顺序对齐容纳了路径长度与采样的差异,但实现仍需固定距离函数、轨迹采样和归一化尺度。尤其在连续环境中,不能把一方的每帧位姿与另一方少数路点任意混用。
4.6 统一算例:相同终点,不同路线
考虑下图的四节点无向图,每条边长 ,只有画出的四条边可通行。指令要求沿 行走,参考路线长 12 米;起点到终点的最短路 只有 4 米。设 。
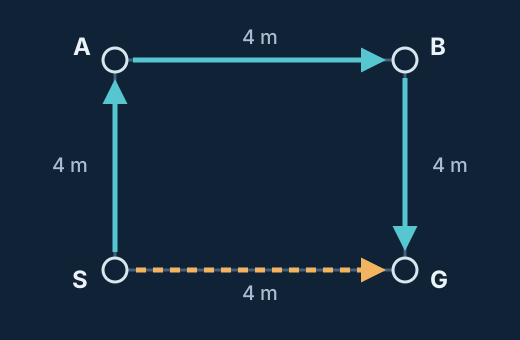
图 2:自定义教学算例。蓝色路线经过两个指定地点,橙色虚线直接到达终点;所有分数由图中边长和本文公式计算,不是模型实验结果。
| 执行路线 | 长度 / 米 | SPL | CLS | nDTW |
|---|---|---|---|---|
| 12 | 0.3333 | 1.0000 | 1.0000 | |
| 4 | 1.0000 | 0.4291 | 0.5134 |
表中为单回合得分。两条路线均在目标处停止,所以成功指示均为 1,终点误差均为零。捷径的 SPL 更高,而参考路线的忠实度更高。
对捷径,参考点 到执行点集合 的最近距离依次是 米,因此
代入长度得分,,得到 。
同一捷径的 DTW 递推如下。行对应 ,列对应执行点 ;左侧是距离矩阵,右侧是累计代价矩阵:
最终累计代价为 8 米,故 。这个结果来自整段路径的有序匹配,不能由终点距离推算。
该算例也说明了指标选择必须服从语言任务:若指令只要求到 ,捷径合理;若要求先经过 、,省略中间地点就改变了任务。
4.7 sDTW:成功与忠实度的联合统计
成功加权的 nDTW(sDTW,也写作 SDTW)先对每个回合相乘,再取均值:
它同时要求终点成功和路线匹配,失败回合贡献零。需要注意,总体 SR 与总体平均 nDTW 的乘积通常不等于 sDTW。指标定义
例如两个回合的 nDTW 为 0.9、0.7,只有第一个成功,则 sDTW 为 ;总体 SR 为 0.5、平均 nDTW 为 0.8,相乘却是 0.4。存在成功回合时,正确分解是
4.8 各项指标的解释边界
| 指标 | 主要衡量内容 | 单独使用时遗漏的内容 |
|---|---|---|
| NE | 最终位置到目标的距离 | 是否按指定路线行动 |
| SR | 在规定条件下最终成功 | 绕路程度、中间地标与顺序 |
| OSR | 是否曾到过目标附近 | 是否能自主正确停止 |
| TL / PL | 实际路径长度 | 是否成功;越短不一定越好 |
| SPL | 成功与最短路效率 | 非最短指令路线的忠实度 |
| CLS | 参考路线覆盖与长度匹配 | 显式访问顺序、终点成功门槛 |
| nDTW | 有序轨迹匹配 | 严格成功条件、物体是否认对 |
| sDTW | 成功条件下的有序匹配 | 失败回合中取得的部分进展 |
CLS 和 nDTW 都把参考路线当作语言执行的代理。如果一句指令允许多条合理路线,单参考评价可能惩罚另一种有效执行。解释结果时,应同时查看语言、轨迹和参考标注,而非把几何匹配分数直接等同于完整语言理解。
五、任务专属指标与实验可比性
5.1 目标定位与交互进展
目标寻找需要明确导航成功与物体定位成功的关系。可以用一般性的联合指标表达这种分工:
表示满足该任务的导航条件, 表示目标预测正确。这是联合成功的通用表示,具体可见性、距离、候选或定位容差仍由数据集定义。REVERIE 中“停在目标可见的位置”与“选对目标”需要分别检查;SOON 的方向定位也不能替换为同名的检测框指标。
对 NDH 一类任务,目标进展可以写成
其中 是可接受目标位置的集合。正值表示接近目标,单位为米;从 12 米外走到 8 米外,进展是 4 米,却未必成功。对话帮助次数和信息预算应与进展一起记录。CVDN
Touchdown 则需要分别评价街景节点上的任务完成与图像位置解析。图节点距离、米制距离和像素误差的量纲不同,不应放在同一列作数值排名。Touchdown 任务定义
5.2 Seen 与 unseen 的划分
在原始 R2R 中,训练和 val-seen 共享建筑环境,但使用不同任务;val-unseen 与 test 使用不同于训练的建筑。原论文给出的划分为:
| 划分 | 建筑关系 | 指令数 | 主要用途 |
|---|---|---|---|
| train | 61 个训练环境 | 14,025 | 参数学习 |
| val-seen | 与训练共享环境 | 1,020 | 已见环境中的任务泛化 |
| val-unseen | 独立的 11 个环境 | 2,349 | 未见环境验证与模型选择 |
| test | 独立的 18 个环境 | 4,173 | 隐藏目标的测试评价 |
数量依据 R2R 原论文;具体复现使用对应版本的划分文件。
换一条指令不会自动产生未见环境;在相同建筑里更换路线,也不等于跨建筑泛化。另一方面,反复使用 val-unseen 选择超参数后,它承担了模型选择作用,仍需要独立测试检验最终结果。
5.3 比较模型之前的协议记录
| 比较维度 | 应明确记录的内容 | 缺失时可能产生的误判 |
|---|---|---|
| 任务和数据版本 | 数据集、split、语言、样本过滤 | 不同任务子集被当作同一难度 |
| 观测权限 | RGB、深度、全景、位姿、候选框 | 额外信息收益被归入模型结构 |
| 地图与动作 | 预给或在线地图、动作粒度、控制器 | 图导航结果被当作完整运动能力 |
| 训练数据 | 人工、合成、预训练与目标域数据 | 数据优势被当作训练算法优势 |
| 推理过程 | 搜索、回溯、重试、步数和调用预算 | 更多探索换来的成功被忽略 |
| 成功和距离 | 阈值、边界条件、停止、测地距离 | 同名指标实际使用不同定义 |
| 统计方式 | 回合数、随机种子、逐回合聚合 | 小样本波动或聚合错误被当作提升 |
此外,报告长度效率时要统计实际执行的探索与回退路程,说明路径输出的含义。保留最终选中的短路径、删去此前走过的分支,会改变对执行代价的评价。导航评测建议
同一批数据上的指标还提供了基本一致性约束:在本文的成功定义与非退化长度条件下,,且 。若表格违反这些关系,应先检查样本集合、归一化、评测版本和实现,而不是直接解释为模型特性。
完整的 VLN 结果应回答三个层次的问题:是否完成任务,是否按照语言约束完成,以及为此使用了什么信息和执行代价。 数据集规定问题边界,动作空间规定决策责任,评价指标则决定哪些行为得到奖励。把这三者对齐,后续关于模型结构、策略学习与机器人部署的比较才有明确含义。
参考资料
- Vision-and-Language Navigation: Interpreting Visually-Grounded Navigation Instructions in Real Environments:R2R、模拟器接口与原始评价协议。
- On Evaluation of Embodied Navigation Agents:SPL 与导航评测条件。
- Stay on the Path: Instruction Fidelity in Vision-and-Language Navigation:R4R 与 CLS。
- General Evaluation for Instruction Conditioned Navigation using Dynamic Time Warping:nDTW、sDTW 与动态规划计算。
- Beyond the Nav-Graph: Vision-and-Language Navigation in Continuous Environments:VLN-CE 的环境和低层动作。
- Room-Across-Room: Multilingual Vision-and-Language Navigation with Dense Spatiotemporal Grounding:RxR 的语言与对齐标注。
- REVERIE: Remote Embodied Visual Referring Expression in Real Indoor Environments:远程物体指代及导航、定位评价。
- SOON: Scenario Oriented Object Navigation with Graph-based Exploration:目标导向探索与定位。
- Vision-and-Dialog Navigation:CVDN、NDH 与目标进展。
- Help, Anna! Visual Navigation with Natural Multimodal Assistance via Retrospective Curiosity-Encouraging Imitation Learning:按需多模态协助。
- Touchdown: Natural Language Navigation and Spatial Reasoning in Visual Street Environments:街景导航与空间描述解析。