VLN 视觉语言预训练:代理任务、数据构造与迁移
视觉语言预训练通过图文恢复、配对判别和动作监督,为导航策略提供可迁移的表示。本文以 PREVALENT 与 Airbert 为主线,解释代理任务的标签来源、室内图文与路线式数据的构造、顺序负样本,以及预训练参数如何进入在线策略,并结合受控实验区分数据与目标的贡献。
上一篇讨论了模仿学习、合成指令和轨迹奖励如何更新策略。本篇进一步讨论:在学习完整导航策略之前,模型应当获得哪些表征能力?
以“经过沙发,在楼梯右侧第二个门口进入走廊”为例,识别沙发和楼梯只是起点。模型还要理解地标出现的先后顺序,判断“右侧”相对于哪个朝向,并在多个门口中选择与指令一致的位置。普通图文匹配提供的监督,对这些能力的约束并不充分。
下文先按监督对象梳理代理任务,再分析 PREVALENT 的动作导向预训练与 Airbert 的室内数据构造,最后讨论下游适配与实验解释。两项方法分别发表于 CVPR 2020 与 ICCV 2021,它们展示了目标函数与数据分布两种互补的设计选择。
一、导航预训练的监督对象与能力边界
设指令为 ,当前观测为 ,历史为 。在线导航最终需要策略:
其中 是模型参数, 属于当前任务允许的动作集合。预训练则可以从轨迹中截取一个时刻、遮住部分输入,或构造一组候选配对,学习更容易批量获得监督的代理任务。代理任务是否有效,取决于它迫使模型保留哪些信息。
| 监督对象 | 典型问题 | 直接约束的能力 | 仍然缺少的条件 |
|---|---|---|---|
| 被遮住的词 | 结合场景补出“右转”中的方向词 | 语言与视觉上下文对齐 | 不直接要求执行后能到达目标 |
| 专家下一步动作 | 当前全景与指令对应哪个方向 | 语义与决策目标对齐 | 单步监督未覆盖策略走偏后的状态 |
| 指令—图像序列的次序 | 同一组房间照片,哪个排列符合描述 | 时序关系与跨模态顺序一致性 | 照片序列不一定对应可通行的真实路线 |
“预训练”描述训练阶段,不限定监督必须来自自监督任务。掩码词预测的答案取自原始文本;专家动作需要轨迹标签;视觉区域分类可能需要检测器或已有标注提供标签。因此,讨论某种预训练能否迁移时,必须同时考察其输入、标签来源和下游使用方式。
二、代理任务:标签来源与优化目标
2.1 局部恢复、配对判别与行动监督
预训练的单位可以是一个词、一块图像区域、一组图文配对,也可以是轨迹上的一步动作。它们的区别首先在于预测什么以及答案从哪里来。
| 代理任务 | 输入与标签 | 约束的关系 | 需要防范的捷径 |
|---|---|---|---|
| 掩码语言建模(MLM) | 遮词后的语言、视觉;标签为原词 | 场景与词义的对应 | 仅凭上下文语言就补出词 |
| 掩码区域建模 | 遮住部分区域;标签可为视觉类别等 | 视觉内容与多模态上下文 | 不同论文的区域标签和损失并不相同 |
| 图文/轨迹配对判别 | 正确配对与错配;标签为是否匹配 | 全局语义一致性 | 只统计共有物体,忽略时序 |
| 动作预测 | 指令、当前状态;标签为专家动作 | 表示与导航决策 | 只记住训练环境中的常见方向 |
| 顺序判别 | 同内容的不同排列;标签为正确排列 | 地标出现次序与语言次序 | 构造过于容易的负样本 |
这是一张任务分类表,不表示每篇方法都使用全部目标。PREVALENT 的核心是 MLM 与 AP;Airbert 在不同训练阶段使用掩码、配对或顺序判别,并针对下游任务适配。PREVALENT,§3;Airbert,§4.2–4.3。
2.2 配对正确不等于路线顺序正确
为说明二元配对判别,设一个指令—视觉序列对为 ,标签 表示配对正确, 为预测概率,则常见二元交叉熵为:
这是判别目标的标准写法。若负样本把“卧室”指令配给全部厨房图片,模型只需识别房间类别就能完成任务;它未必学会“先经过厨房,再进入卧室”。Airbert 的顺序打乱负样本保留图片和描述的语义成分,仅改变排列,迫使模型关注顺序。下面的 Airbert 小节会展开其候选组交叉熵;它与上述二元损失的归一化对象不同。
2.3 多任务组合与监督边界
采用多种代理任务时,可将训练目标统一记作:
是任务集合, 是该任务的样本分布, 表示相对权重。这是多任务训练的抽象:具体实现可以在同一批数据上计算多个损失,也可以交替采样任务;论文报告的等权损失不能自动转写为任意实现都使用相同采样频率。
损失的数量、归约方式和任务采样共同决定更新强度。例如一个样本有多个被遮词,却只有一个动作标签,如果 MLM 按 token 求和而 AP 按样本平均,二者数值规模会不同。阅读实现时,应连同掩码比例、有效标签计数和采样配比一起理解目标函数。
预训练数据仍有信息边界:用于监督的未来动作或目标不能成为推理时偷偷提供的输入;验证场景也不能因为使用了“无标签图像”就自动获得训练豁免。下游迁移是否有效,需要在规定的数据与环境划分下验证。
三、PREVALENT:动作导向的跨模态对齐
3.1 从全景观测到跨模态表示
PREVALENT 以“指令—当前全景—专家动作”三元组组织预训练。它的关键选择,是让语言理解和动作预测共享跨模态表示。
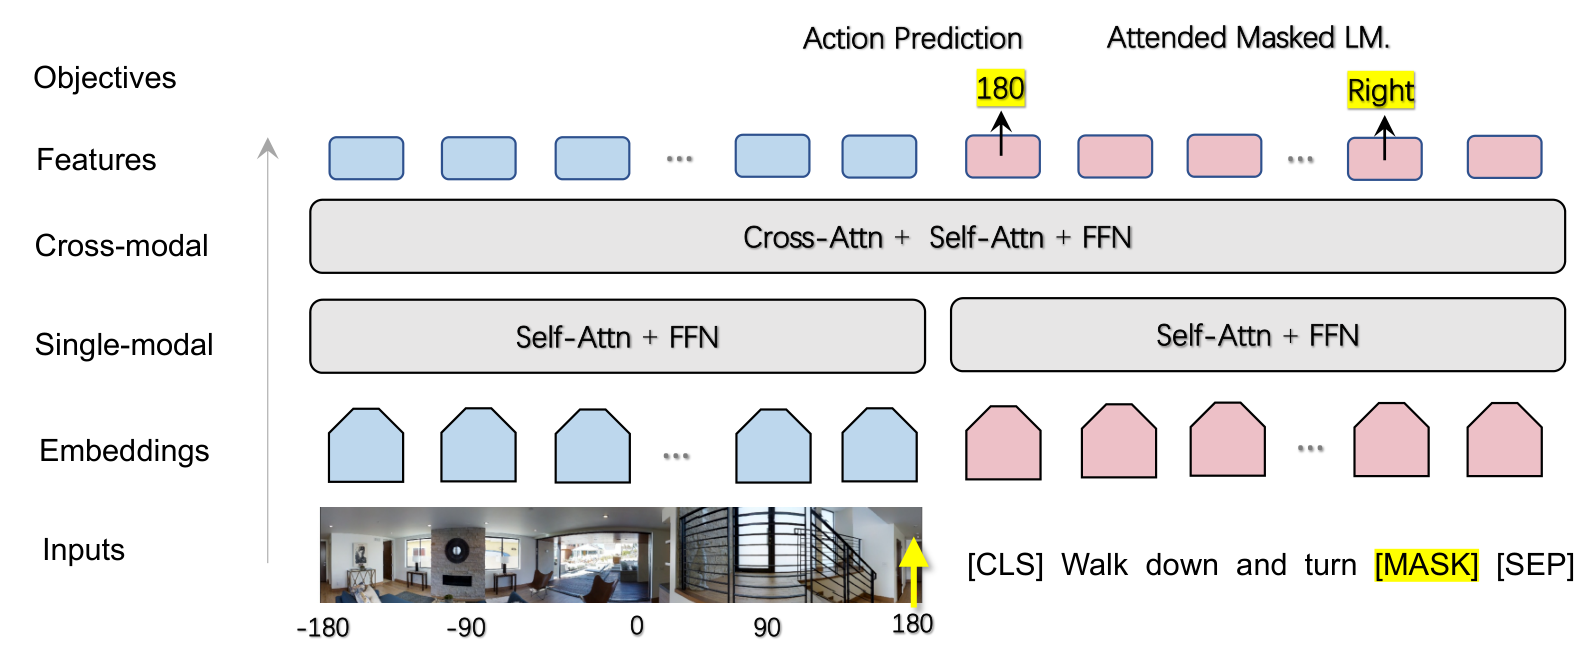
图 1|Weituo Hao 等,Towards Learning a Generic Agent for Vision-and-Language Navigation via Pre-training,CVPR 2020,原论文 Figure 3。截取图区域,内容未改绘。论文来源 · 查看原尺寸。
按图从下向上阅读:左侧为不同朝向的视觉输入,右侧为指令词元;两路先进行单模态编码,再通过跨模态注意力交换信息。顶端的两个预测头共享这层融合结果:[CLS] 对应动作预测,[MASK] 所在位置对应词预测。图中的角度是方向标签示意。
模型把一个全景离散为 36 个视图,即 12 个水平朝向与 3 个仰角的组合。每个视图不仅包含图像特征,也包含方向特征:
和 分别表示视图的航向角与仰角; 是 2048 维 ResNet 特征;重复后的方向向量为 128 维,拼接得到 2176 维输入,再投影到模型隐空间。使用正余弦可以避免角度跨过 与 时出现数值跳变。
方向编码使模型有条件区分“同一个物体出现在左侧还是右侧”。视觉特征负责描述内容,角度特征保留内容与动作方向之间的联系;仅把各方向的特征平均起来,会损失这部分结构。
3.2 掩码语言建模与动作预测
令 , 为被遮住的词位置集合。掩码语言建模(MLM)的损失可写成逐词形式:
是训练样本分布, 表示掩码后的指令。论文选择约 15% 的词进行掩码。模型需要依据剩余语言和全景推断目标词;例如“在楼梯右侧……”中的“楼梯”可能借助视觉补全,而方向词还需要结合上下文判断。
动作预测(AP)则以专家方向 为分类标签:
动作头读取融合后的 [CLS] 表示,通过分类层预测方向。这里的专家动作是待预测标签,并不是提供给 MLM 的答案输入。MLM 要求表征保留可恢复的语义,AP 则要求这份语义能够支持动作判别。
两个目标存在互补关系,但都不能替代完整策略训练。PREVALENT 在这一预训练阶段按指令采样单个状态—动作对,动作头没有显式建模整段执行历史;它学习的是当前状态下的动作相关表征。
3.3 预训练表示如何进入导航策略
在论文的 R2R 实验中,预训练模型得到的上下文化词表示被送入下游 LSTM 编码器—解码器导航模型。下游仍负责历史状态更新、逐步动作选择以及终止决策。
这体现了预训练和策略的分工:预训练改善可供决策使用的表示,下游训练决定这些表示如何随交互持续更新。 PREVALENT 还利用合成指令扩大训练样本,但合成数据的场景基础仍受训练环境覆盖限制。由此自然引出 Airbert 的问题:能否从训练扫描场景之外获得更丰富的室内图文关系?
四、Airbert:室内数据覆盖与顺序一致性
4.1 从房源图文到路线式样本
Airbert 使用 BnB 室内房源数据进行领域内预训练。经清理,数据包含约 71.3 万个图文对,以及约 67.6 万张没有描述的图片。这里的“领域内”指室内视觉和语言与导航任务相近,并不意味着这些数据已经包含可执行的导航轨迹。
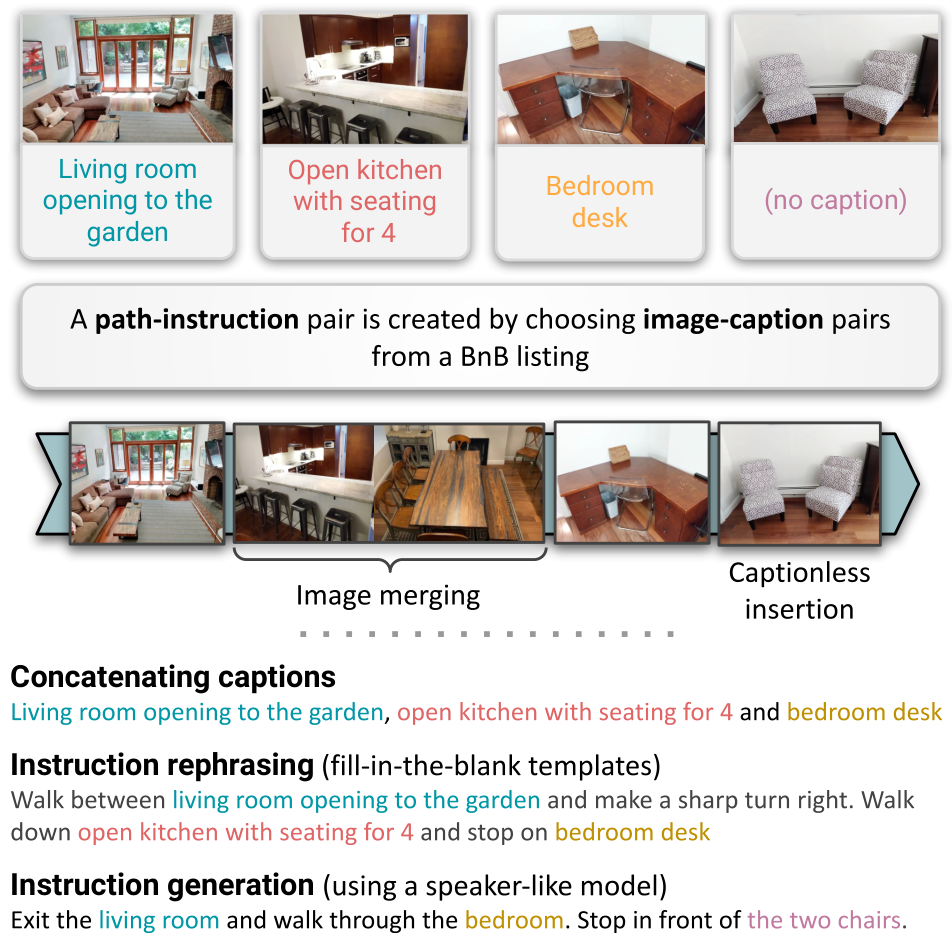
图 2|Pierre-Louis Guhur 等,Airbert: In-domain Pretraining for Vision-and-Language Navigation,ICCV 2021,原论文 Figure 2。截取图区域,内容未改绘;原文采用 CC BY 4.0。论文来源 · 查看原尺寸。
图中上层给出原始图片和描述,中层构造图像序列,下层展示三种语言构造方式。图像合并和无描述图片插入作用于视觉序列;描述拼接、模板改写和模型生成提供不同的文本版本。
论文从同一房源选取 4–7 个图文对,避免把不同住所随意拼成一段经历,再通过以下操作缩小数据形态与导航数据之间的差异。
| 操作 | 具体处理 | 对应的导航特征 | 使用边界 |
|---|---|---|---|
| 描述拼接(Cat) | 用连接词或标点串联多张图片的描述 | 指令涉及多个位置 | 语言可能更像对象清单 |
| 图像合并(Merge) | 合并预测为同类房间的图像区域特征 | 一个位置可观察多个视角 | 同类房间不等于同一真实位置 |
| 无描述图片插入(Insert) | 插入没有文本描述的图像 | 途中观测并非都被指令提及 | 模型需要处理视觉与语言的非一一对应 |
| 指令改写(Rep) | 将 BnB 名词短语填入 R2R 指令模板 | 引入路线式句法与连接关系 | 句法合理不保证空间关系真实 |
| 指令生成(Gen) | 用经过图文和路线数据训练的生成模型描述序列 | 获得更接近导航的表达 | 受生成模型误差影响 |
这些操作是可比较、可组合的数据策略。尤其是模板改写和模型生成,它们并不是每个样本都必须依次经过的两道处理。即使生成了“穿过客厅进入卧室”,照片仍未提供真实的门洞连接、相机位姿或可通行性;这类数据适合学习语言和视觉关系,不能直接充当机器人运动轨迹。
4.2 打乱顺序形成困难负样本
如果指令和图像序列中都出现客厅、厨房、卧室,只判断物体是否重合,很容易忽略先后关系。Airbert 因而引入顺序打乱任务:保留语义内容,改变图像或描述的排列,使模型区分一致的正样本与顺序失配的负样本。
令 表示正确的指令—序列配对, 为打乱得到的负样本, 为匹配得分:
分母在同一候选组中归一化。损失下降意味着正确顺序相对打乱顺序获得更高得分,而不是只把某个配对的绝对得分增大。
例如,一个正样本和两个负样本的得分分别为 ,则:
若三者得分相同,正确样本概率仅为 ,损失为 。这是用于说明目标函数的算例。实际训练还结合文本/视觉掩码任务,模型必须同时掌握局部语义与跨位置顺序。
4.3 数据策略与下游协议
下表摘自 Airbert Table 2,统一为 R2R val-unseen、候选路径选择设置。这些行均使用掩码与顺序打乱预训练,便于观察不同数据构造策略的影响。
| BnB 数据构造 | SR(%) |
|---|---|
| 描述拼接 Cat | 62.71 |
| 指令改写 Rep | 63.35 |
| 指令生成 Gen | 63.11 |
| 图像合并 Merge | 64.07 |
| 无描述图片插入 Insert | 66.05 |
| Rep + Merge + Insert | 66.52 |
组合策略相对 Cat 提高 3.81 个百分点。Insert 的结果提示,让训练样本包含“沿途看到但没有被说出来”的内容,对这种设置下的泛化有帮助。表中没有多次运行的置信区间,因此小差值不宜解读为稳定的严格排名。
Airbert 还区分两种下游适配:判别式模型对候选路径打分,生成式模型结合 Recurrent VLN-BERT 进行逐步动作预测。前者依赖候选路径的生成和搜索条件,后者需要在交互过程中决定下一步动作。路径重排序的 SR 与单次在线导航的 SR 不能直接作为模型能力排名。
五、从预训练参数到在线导航策略
5.1 初始化、适配模块与交互数据
完成预训练后得到参数 ,下游策略还可能包含新建的历史模块和动作头,记其参数为 。迁移过程可抽象为:
是编码后的当前多模态表示。式中的分工帮助区分“复用表示”和“复用整套策略”,不要求所有方法都把网络拆成同样两个代码模块。微调时哪些参数冻结、哪些更新,应按具体方法确定。
| 迁移环节 | PREVALENT 的 R2R 用法 | Airbert 的两种用法 |
|---|---|---|
| 复用内容 | 动作导向的跨模态表示 | 室内图文与路线式序列预训练骨干 |
| 下游结构 | 上下文化词表示接入 LSTM 导航模型 | 候选路径打分,或接入 Recurrent VLN-BERT 的循环策略 |
| 决策单位 | 交互过程中的下一步动作 | 一条候选路径,或交互中的下一步动作 |
| 仍需学习 | 历史状态、动作选择和停止 | 任务路径排序,或状态递推和动作选择 |
Airbert 的判别式适配先在目标任务的路径—指令对上使用掩码与打乱目标,再以能够抵达目标附近的候选路径作正样本进行排序训练。生成式适配则把 [CLS] 状态递推与当前视觉候选结合,每步预测动作。相同预训练骨干可以进入不同推理流程,骨干名称本身不能说明动作空间或搜索预算。 Airbert,§4.3。
5.2 领域接近与执行能力之间的距离
室内照片可以改善房间和对象的表示,路线式文本可以改善地标顺序建模,但它们通常不携带真实的相机运动、碰撞结果和偏航恢复过程。从静态图文到导航,有三类缺口需要分别处理:
- 观察缺口:图像风格、相机高度、视野与遮挡改变可见证据。
- 交互缺口:动作会改变下一次观察;模型预测出正确动作类别并不意味着底层运动能完成。
- 分布缺口:在线策略会进入训练轨迹之外的状态,需要相应的交互监督或恢复机制。
因此,预训练目标下降是中间证据。判断其导航价值,最终仍要看固定协议下的在线表现,以及改变数据或目标后的受控实验。策略访问状态上的学习方式可回看策略学习篇。
六、实验依据:区分数据、目标与迁移方式
6.1 顺序监督的对照证据
下表摘取 Airbert Table 3 的第 1、3、4、5 行,均为 R2R 候选路径选择,保留 R2R 排序微调;这些行没有加入该表的 Speaker 扩展数据。
| BnB 预训练 | R2R 阶段额外打乱目标 | val-seen SR / % | val-unseen SR / % |
|---|---|---|---|
| 无 BnB 阶段 | 否 | 70.20 | 59.26 |
| 掩码 | 否 | 73.24 | 64.21 |
| 掩码 + 打乱 | 否 | 73.57 | 66.52 |
| 掩码 + 打乱 | 是 | 74.69 | 66.90 |
在相同 BnB 数据构造和后续排序设置下,加上预训练打乱目标,val-unseen SR 从 64.21% 增至 66.52%,提高 2.31 个百分点。继续在 R2R 适配中加入打乱目标,则增至 66.90%。它支持顺序监督在该设置中的作用,不能将全部提升都解释成新损失的收益:第一行与后面几行还存在 BnB 训练阶段的差异。
第四章的数据构造表回答“怎样生成更有效的预训练样本”,本表回答“同类数据上增加顺序约束是否有效”。两张表的变量不同,合并成一个最好成绩排行榜会丢失因果解释。
6.2 一次迁移实验应固定什么
| 要检验的因素 | 建议固定的条件 | 对应比较 |
|---|---|---|
| 额外数据的作用 | 骨干、目标、下游协议及计算预算说明 | 无额外数据与加入额外数据 |
| 领域匹配的作用 | 数据规模、目标与适配方式 | 通用图文与室内图文 |
| 代理任务的作用 | 数据、网络、训练步数和微调设置 | 掩码与掩码+顺序判别 |
| 参数迁移的作用 | 在线策略、动作集合与训练数据 | 随机/通用初始化与导航预训练初始化 |
| 历史与地图的作用 | 预训练方案与下游监督 | 不同历史或空间表示,转入地图篇讨论 |
表中是实验设计建议,不是声称上述所有控制都已在两篇论文中完成。资源预算不同的结果,应如实列出训练量,避免把更多计算和某个结构变化混为同一贡献。
6.3 实现检查:一条预训练样本的生命周期
选择“指令—全景—专家动作”作为样本时,可以沿着以下顺序检查数据流:先确认指令与观测属于同一回合、同一时间步;再分别生成语言掩码和动作标签;编码后由 MLM 头预测词,由 AP 头预测专家方向;最终只在有效词位置和合法动作范围内计算相应损失。
| 检查点 | 应保持的对应关系 | 常见错误 |
|---|---|---|
| 样本 ID 与时间步 | 语言、观测、标签来自同一记录 | 打乱批次后动作标签没有同步重排 |
| 掩码 | padding、被遮词和动作合法性分别表示 | 把 padding 当作 MLM 目标 |
| 专家动作 | 目标索引对应该样本的方向/候选定义 | 直接使用另一种动作空间的整数编号 |
| 验证划分 | 预训练数据与下游划分约束一致 | 混入未见验证场景后仍称泛化评估 |
| 迁移接口 | 载入权重、输出维度和下游模块一致 | 动作头重建后误称整个策略已迁移 |
PREVALENT 说明了动作标签如何改变图文表示的学习方向;Airbert 说明了数据领域、路线式构造和顺序约束如何影响迁移。下一步的问题是:获得这些表示以后,如何把不同时刻的观察放进一个可探索、可返回的空间结构?这将由地图表示与决策篇展开。
参考资料
- Weituo Hao, Chunyuan Li, Xiujun Li, Lawrence Carin, Jianfeng Gao. Towards Learning a Generic Agent for Vision-and-Language Navigation via Pre-training. CVPR 2020,输入表示、MLM/AP 与下游适配。
- Pierre-Louis Guhur, Makarand Tapaswi, Shizhe Chen, Ivan Laptev, Cordelia Schmid. Airbert: In-domain Pretraining for Vision-and-Language Navigation. ICCV 2021,§4.2–4.3、Tables 2–3。
文中论文原图的权利及使用条件归原作者与相应权利人,第三方图片不纳入本站原创内容的许可声明。