VLN 地图表示与决策:拓扑记忆、双尺度融合与空间推理
历史记忆可以保存曾经看见的地标,地图进一步组织这些地标所在的位置、连接关系和未探索方向。本文以 DUET 与 BEVBert 为主线,解释在线拓扑建图、全局与局部动作对齐、双尺度分数融合,以及 RGB-D 特征如何形成局部度量地图,并用算例和消融分析说明不同空间表示的作用。
预训练篇讨论了表示如何从数据和代理任务中获得导航相关知识。这里继续讨论表示的组织方式:当模型已经走过两条走廊,发现目标更可能在早先看到但尚未进入的房间时,怎样选择那个房间,又怎样返回通向它的路口?
这涉及三个层次:记住观测、选择空间目标、执行通往目标的路线。下文以离散视点图环境中的 DUET 和 BEVBert 为范围。论文中的位置、邻接候选和深度条件会明确列出;其图上导航机制不直接等同于真实机器人的定位与避障。
一、从时间记忆到空间地图
1.1 观测序列与位置关系
设指令为 ,当前位置为 ,已经观察到的地图为 。节点集合记录位置,边集合记录已知连接。一个抽象的在线更新过程是:
是当前观测, 是当前可到达的邻接位置。该式表示数据流,具体节点表示和更新机制由模型决定。位置图也不意味着预先知道完整环境: 只覆盖已经到过或从到过的位置观察到的区域。
| 表示 | 索引依据 | 直接保存的信息 | 决策时需要补足的关系 |
|---|---|---|---|
| 循环状态 | 当前时间步 | 压缩后的语言与经历 | 旧地点、先后次序和连接关系需隐式恢复 |
| 显式历史序列 | 观测时间 | 多个时刻的视图、动作与步序 | 同一位置重复出现时的空间关联 |
| 拓扑地图 | 位置节点 | 地点、连接与探索状态 | 节点内部的几何和物体细节 |
| 局部度量地图 | 空间栅格 | 地标相对方向、距离与局部布局 | 超出局部覆盖范围的长程结构 |
同一门口被两次看见,在时间序列中可能对应两个条目,在位置图中则可以更新同一个节点。反过来,把一个全景平均成一个节点向量,也会压缩“桌子左侧的小物体”等细节。DUET 用局部细粒度分支补充拓扑节点;BEVBert 进一步把局部视觉写入度量栅格。
1.2 地图节点、候选目标与执行路线
把已访问节点记为 ,尚未访问但已经被观察到的候选记为 。在本文讨论的常用设置中,全局目标集合为:
已访问节点仍参与地图编码和路由,但可以从“下一探索目标”中屏蔽。设模型选择了远端目标 ,执行路线是当前图上的一条路径:
因此,屏蔽旧节点作为探索终点,并不禁止执行路线经过旧节点。也不能把 的节点 ID 直接当作当前模拟器的邻居索引;一个全局选择可能需要沿图经过多个局部位置。DUET,§3.1–3.3。
二、DUET:全局拓扑与局部细粒度表示
2.1 在线建图与两种特征粒度
DUET 的输入包括当前全景、语言、位置信息,以及任务适用时的对象候选。全景被划分为多个带朝向的视图;对象特征来自候选框。全景视图与可导航方向不是相同集合,只有部分视图对应邻接节点。
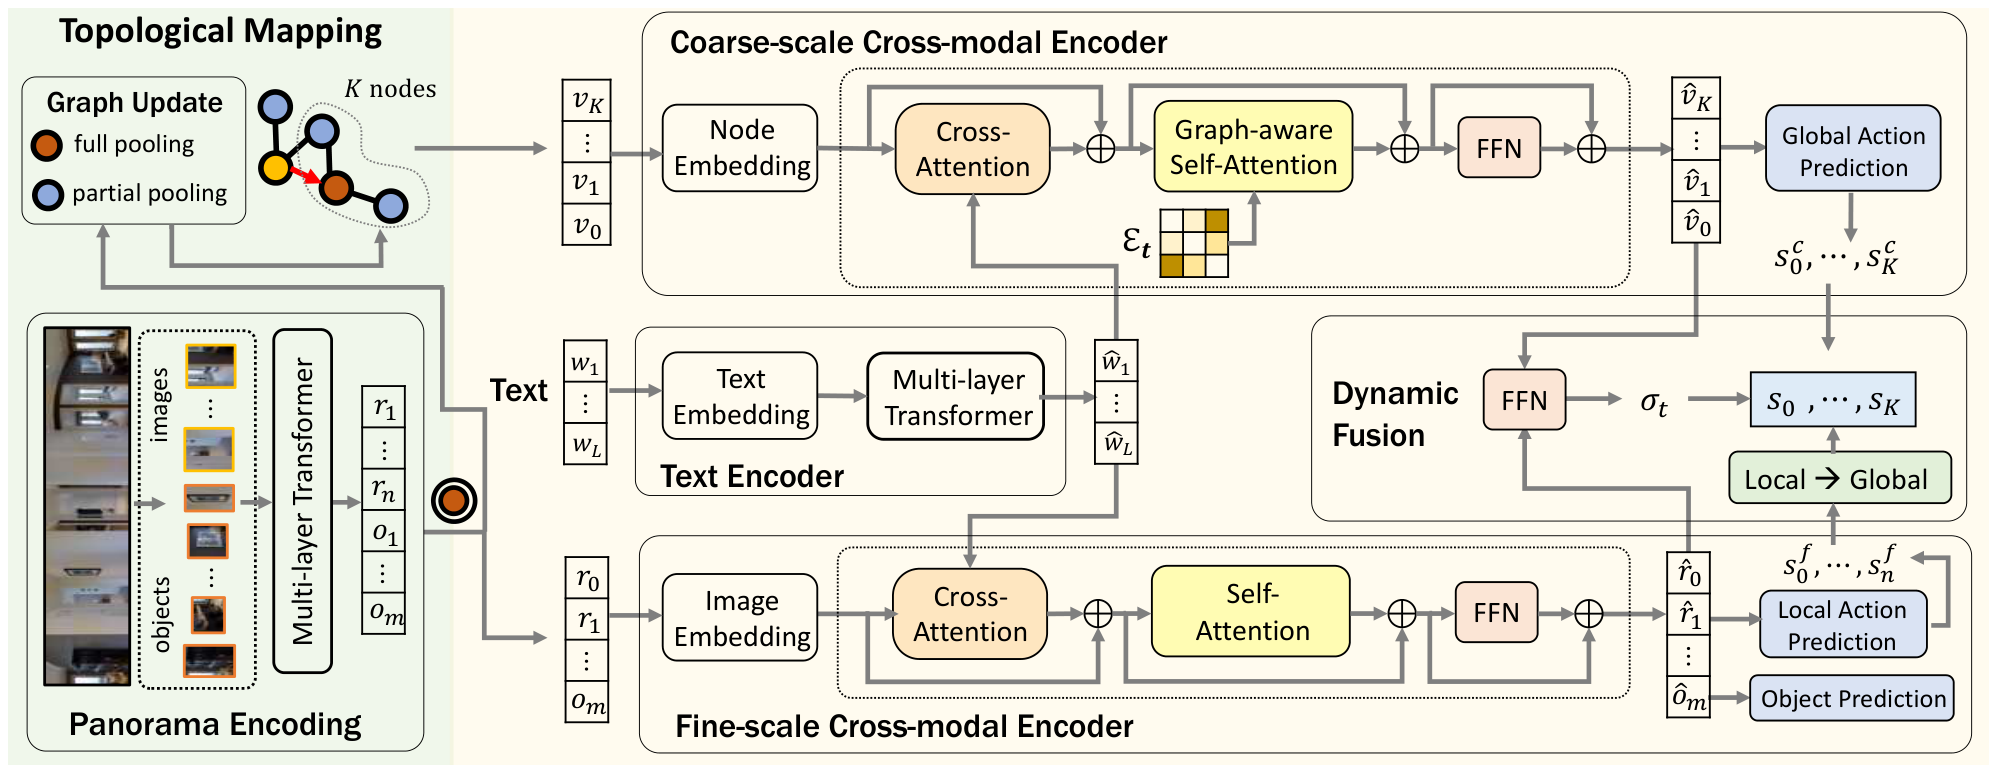
图 1|Shizhe Chen、Pierre-Louis Guhur、Makarand Tapaswi、Cordelia Schmid、Ivan Laptev,Think Global, Act Local,CVPR 2022,原论文 Figure 4。截取完整图区,内容未改绘;版权归原权利人。论文 · 原尺寸。
从左到右读图:当前视图和对象经过全景编码;一条路径将其汇聚成节点特征并更新图,进入上方粗尺度分支;另一条保留视图和对象 token,进入下方细尺度分支。两路都读取中间的语言表示。右侧 Local → Global 先对齐动作含义,再由 Dynamic Fusion 合并分数。
对当前位置,DUET 对编码后的全景视图与对象特征作平均汇聚,形成较紧凑的节点表示。对尚未到达的候选,只能使用已有位置朝向该候选的视图特征;从不同位置重复观察同一候选时,聚合这些局部观察。未知区域不会凭空具有到达后的完整全景。
节点表示再加上相对当前位置的方向/距离,以及访问步序编码。已访问节点使用最近一次访问的步序,未访问节点使用零步序。额外的 STOP token 对应在当前位置停止,不是一处新的物理地点。
2.2 图感知注意力
普通自注意力只依据内容相似度分配权重;DUET 为节点之间加入图关系偏置。省略多头和残差等外围结构,原文的图感知自注意力可写为:
为节点表示, 为从图连接得到的成对距离矩阵, 为可学习映射参数。Softmax 按每个查询节点对应的候选节点维度归一化。图关系影响的是注意力权重,而不是直接指定输出动作。DUET,式(3)–(4)。
对于隔墙相邻的两个位置,图中通路与空间直线距离可能明显不同。阅读距离编码时需要分清其来源,不能把图距离、方位角和视觉相似度当作一种信息。GASA 学习如何使用图关系;选择目标之后的最短路规划仍是另一个环节。
2.3 全局动作、局部动作与对象预测
全局分支将节点与语言融合后,为图上目标输出分数 ;局部分支将当前视图、对象和语言融合后,为邻居与 STOP 输出 。两路的“粗/细”首先指表示粒度和决策范围,不能理解为同一图像简单换两个分辨率。
| 分支 | 视觉单位 | 导航输出范围 | 主要作用 |
|---|---|---|---|
| 粗尺度全局分支 | 每个位置的汇聚节点特征 | 已观察地图中的未访问目标与 STOP | 长程探索、返回其他分支 |
| 细尺度局部分支 | 当前视图与对象 token | 当前邻接动作与 STOP | 指令与当前细节的对应、停止判断 |
| 对象预测头 | 当前对象候选特征 | 当前位置的对象候选 | REVERIE 等任务的目标指认 |
REVERIE 使用给定候选框,SOON 的对象候选由检测器产生;R2R 没有最终对象指认要求。导航成功与对象指认成功需要按任务分别报告,不能把对象头作为所有 VLN 模型的必备模块。
三、DUET 的动作空间对齐与动态融合
3.1 远端目标如何获得局部支持
全局图里可能存在远端房间 ,但当前相机只看到邻居 。局部分支没有 对应的直接输出,因此不能对两个分数数组按下标相加。
DUET 先把已访问邻居的局部 logits 相加,构成回溯支持:
对当前邻接候选和 STOP,保留自己的局部分数;对非邻接的未访问目标,用共同的回溯分补足:
这是原文式(6)在有效目标集合上的展开。回溯分是 logit 之和,不要求落在 ,也不是“先 softmax 再加概率”。多个远端候选得到相同的局部支持,它们的区别主要由全局分支的节点分数保留。
3.2 门控与候选排序
将两个分支的 STOP 表示分别记为 ,门控及融合分数为:
这里以 对应原论文的 ,避免与其他章节的 sigmoid 函数符号混淆。两层前馈网络读取状态相关的 STOP 表示,预测本次决策应当怎样平衡全局和局部证据。无效目标先排除,再归一化。
假设局部有未访问邻居 、已访问邻居 ,全局另有非邻接未访问目标 。取 ,演示如下:
| 全局可选动作 | 全局分数 | 对齐后的局部分数 | 融合分数 |
|---|---|---|---|
| 2 | 1 | 1.6 | |
| 3 | 0.5(来自 的回溯分) | 2.0 | |
| STOP | 0 | −1 | −0.4 |
该算例中模型选择 。 可以出现在通向 的执行路径上,但它不是此次探索目标。若有两个已访问邻居,应按定义相加两者的局部分数,而不是擅自选最大分或给远端候选填零。
3.3 图上决策与实际移动
DUET 在已构建图上用 Floyd 最短路径路由到选中的目标。全局选择减少了逐步“决定是否继续回头”的次数,但路径上的实际移动仍应完整计入轨迹长度。远端目标不是一次不计距离的瞬移。
停止机制也不只有普通 STOP 选择:论文在超过最大决策步数时强制终止,并返回停止概率最高的节点作为最终位置;对象指认在最终停止位置执行。复现其结果时,需要把这个终止规则和额外返回路径一起纳入协议。
四、BEVBert:拓扑结构与局部度量空间
4.1 两类地图保存不同的信息
把历史图像依次存起来,可以回答“以前看见过什么”,却未必能直接回答“这些观测之间有什么空间关系”。BEVBert 将历史组织为拓扑图与局部鸟瞰度量图,并分别与指令进行融合。
| 表示 | 基本单元 | 适合表达的信息 | 主要限制 |
|---|---|---|---|
| 观测序列 | 按时间排列的图像/视图 | 出现顺序与历史上下文 | 空间邻接关系需要隐式学习 |
| 拓扑图 | 位置节点与连接边 | 已探索结构、长程候选目标和回溯路径 | 节点内部的细粒度布局较粗 |
| 局部度量图 | 以智能体为中心的空间栅格 | 附近地标的相对方向与距离 | 覆盖范围有限,依赖深度和位姿 |
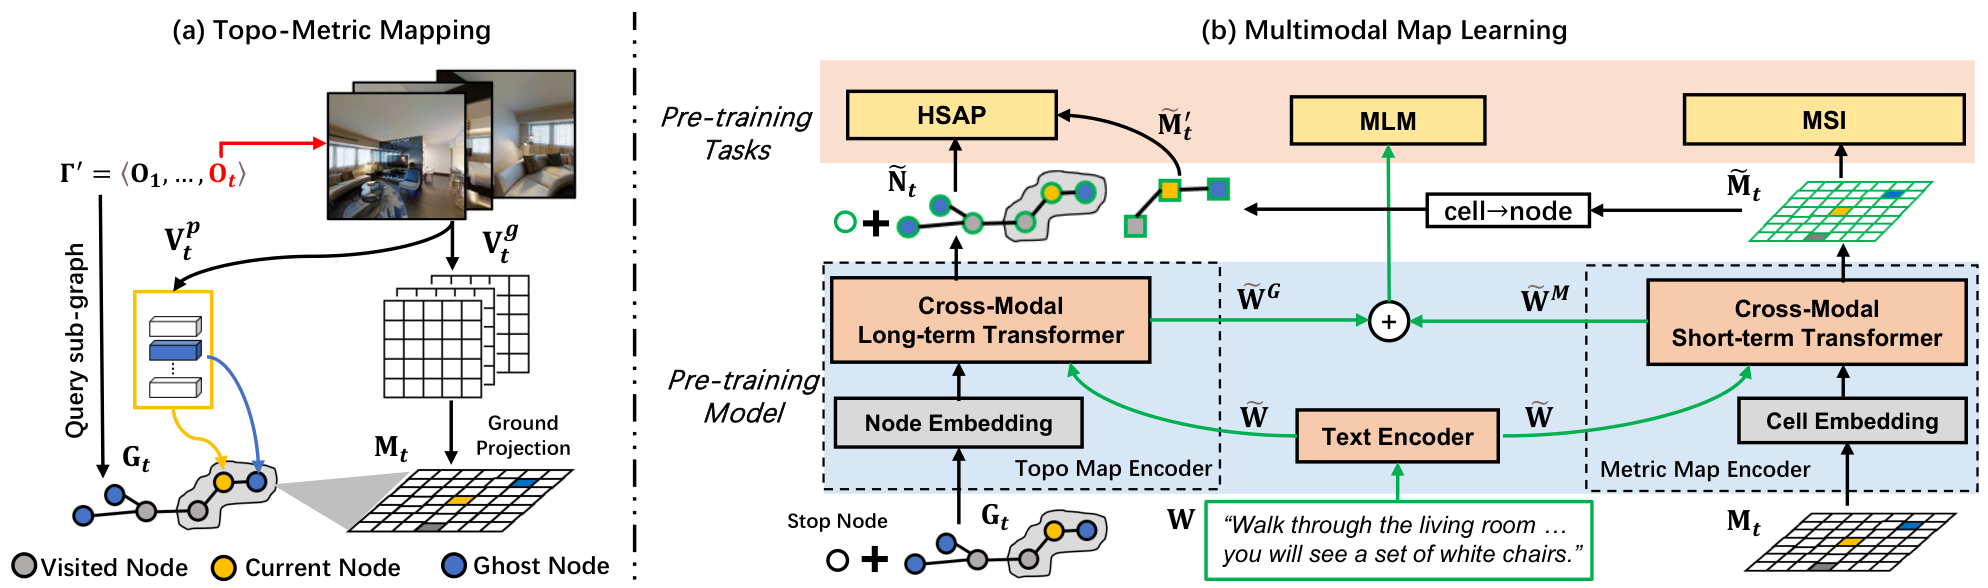
图 2|Dong An 等,BEVBert: Multimodal Map Pre-training for Language-guided Navigation,ICCV 2023,原论文 Figure 2。截取图区域,内容未改绘;原文采用 CC BY 4.0。论文来源 · 查看原尺寸。
先看图(a):同一批观测产生全景特征 与图像网格特征 ,分别用于拓扑节点和地面投影。再看图(b):拓扑分支进行节点级跨模态融合,度量分支进行栅格级跨模态融合;顶部三个预测头对应下一节的训练目标。图中的 cell→node 用于对齐两个分支的动作候选,并非把整张栅格图永久压成一个节点。
4.2 拓扑图的在线维护
拓扑图写作 。节点区分已访问位置、当前位置,以及已被观察到但尚未访问的候选位置(ghost nodes)。智能体移动后,将新观察到的候选位置加入图中,更新节点特征和访问状态。
已访问节点可以积累该位置的全景信息;尚未到达的候选位置只能依据指向它的已有观测形成表示。节点还加入相对于当前位置的方向、距离和访问时间等编码。随后,图感知注意力利用连接结构编码节点,再与语言交互。
这里的“全局”指相对于当前已构建地图的长程决策范围。它并不代表智能体预先掌握整栋建筑。在论文的离散环境设置中,每一步的可导航候选节点由模拟器提供;推广到真实环境,还需要相应的候选位置生成机制。
4.3 从 RGB-D 观测到局部栅格
度量图的构造先提取二维视觉特征,再利用对应的深度和相机位姿投影到空间。BEVBert 使用 ViT-B/16-CLIP 的 图像网格特征,把附近访问节点的观测汇入以当前智能体为中心的地图。
下面用标准针孔相机模型展开投影过程。设像素坐标为 ,内参为 ,深度 表示沿相机光轴的距离,则相机坐标系中的点为:
若深度传感器提供的是沿射线的欧氏距离,应先归一化射线方向,再乘该距离,不能直接代入这里的光轴深度。图像经过缩放、裁切后,也需要使用与当前像素坐标一致的内参。
设 将相机坐标变换到世界坐标; 表示当前智能体坐标系相对于世界坐标系的姿态和位置,则:
这样,不同时间、不同相机朝向获得的特征才能落到同一个当前局部坐标系。只把旧图像特征叠加,而不进行位姿变换,会把相机运动混入物体布局。
为说明栅格化,约定局部坐标 向前、 向左,地图有 个栅格,边长为 ,采用从零开始的索引:
越界点不写入当前地图;有效点按其平面位置分配到栅格。对落入同一格的特征集合 ,可以进行逐维平均:
空集合对应未观测格,需要保留未知状态。这里聚合的是视觉特征,而非凭空生成一块已知可通行空间。
投影算例。 设 、,像素为 ,光轴深度为 ,则 。假设相机位于智能体原点,光轴朝前;相机的右、下、前分别映射到智能体的右、下、前,那么 。在 、 的地图中,该点写入 。这个坐标约定用于演示几何过程,具体实现必须统一自身轴方向和数组索引。
论文默认的 地图覆盖 。它保留附近布局,并通过拓扑图补充更远处的结构。栅格编码还包含相对极角、距离和是否属于局部动作集合的信息,使视觉内容能够与“右侧”“附近”等空间词发生对应。
五、混合地图上的预训练与动作决策
5.1 两路地图表示的分工
BEVBert 的拓扑编码器输出节点表示 ,度量编码器输出栅格表示 ;二者分别与同一条指令融合。前者侧重长程候选目标,后者侧重局部几何关系。
MLM 仍然预测被遮住的词,但条件由单个全景扩展为混合地图:
论文将两路跨模态分支得到的语言表示相加,再送入词预测头。这样,恢复一个词时可以同时使用拓扑历史和局部布局。
5.2 HSAP:全局与局部动作分数融合
混合单步动作预测(HSAP)首先在两个分支中独立打分。将局部候选位置所在的栅格映射回对应拓扑节点后,记其分数为:
指已经对齐到节点 的栅格表示。若全局动作集合为 ,能获得局部栅格分数的节点集合为 ,融合为:
门控权重 由当前状态计算:
是停止节点表示, 是智能体所在的中心栅格, 为 sigmoid。局部地图覆盖的候选使用双分支融合;其他长程候选保留拓扑分数。后者并非把不存在的局部分数当作零再加权。
例如,三个候选 的拓扑分数为 ,局部地图只覆盖 ,其局部分数为 。令 ,则:
拓扑分支原本偏向 ;加入局部空间信息后, 得分最高,而 的分数保持 。训练时对有效动作进行 softmax,用专家动作 计算交叉熵:
论文屏蔽已访问节点作为新的目标候选。推理时选择得分最高的未访问候选或停止节点;若目标不与当前位置相邻,则在已构建拓扑图上用 Dijkstra 算法规划到它的路径。目标节点的屏蔽与途中是否可以经过旧节点是两回事:到达远端候选的路径仍可能穿过已访问位置。
5.3 MSI:掩码栅格的多标签语义预测
地图存在未观测区域。BEVBert 的掩码语义想象(MSI)随机遮住约 15% 的度量栅格,要求模型利用指令与剩余地图预测这些格子的语义。
一个栅格可能同时包含多个类别,因此不能用互斥的单类 softmax。令 表示被遮住的格子 是否含有类别 ,预测概率为 。把论文目标展开到栅格和类别,可写成二元交叉熵:
这里 由独立 sigmoid 输出,40 类监督标签来自 Matterport3D;求和也可按实现归约为均值。目标是恢复语义类别,而非重建原始视觉向量或像素。
例如某格的监督同时包含“墙”和“门”,两类概率都应增大;错误的“床”类别概率则应降低。MSI 让模型学习室内布局与指令的统计联系,但推测出的语义仍有不确定性,不能直接当作障碍物已消失或通道必定存在的证据。
5.4 从离线预训练到在线微调
预训练阶段混合使用 MLM、HSAP 和 MSI;微调阶段则在连续决策过程中更新地图,并交替使用 teacher forcing 与 student forcing。后者根据当前模型分布采样动作,在实际到达的状态上重新获得监督目标。
其微调损失可概括为:
两项均是相应状态分布上的动作交叉熵, 控制专家轨迹部分的权重。对 R2R 等任务,student forcing 的伪标签依据地图上通向终点的候选目标构造;对强调路线忠实度的 RxR,论文使用与 nDTW 相关的目标选择依据。因此,标签设计仍受任务评测目标约束。
模型执行自身动作,并不自动意味着使用强化学习。这里仍依靠动作标签进行模仿学习;区别在于训练状态由谁生成,以及偏离专家路线后如何重新给出合适监督。
六、消融证据与方法比较
| 比较维度 | DUET | BEVBert |
|---|---|---|
| 全局表示 | 在线拓扑节点与连接 | 在线拓扑节点与连接 |
| 局部表示 | 当前全景视图与对象 token | 多次 RGB-D 观察投影形成的局部度量栅格 |
| 远端候选的局部支持 | 汇总已访问邻居的局部 logits 作为回溯分 | 局部地图覆盖外的候选保留全局分数 |
| 特有输入条件 | 位置与邻接候选;对象任务需要对象候选 | 位置、邻接候选与深度信息 |
| 局部语义监督 | 对象任务中的目标指认等 | 掩码栅格的多标签语义预测 |
| 需要分别验证 | 探索范围、停止与对象指认 | 地图结构、深度条件与空间监督 |
两种方法都保留全局拓扑信息,但局部信息的组织方式不同。以下消融分别检验其设计,不把来自不同任务和训练设置的结果合成性能排名。
6.1 地图结构带来的变化
BEVBert Table 5 在 R2R val-unseen 上比较地图设计。下表保留完整的地图/深度条件;TL 为轨迹长度(米),SR 与 SPL 均以百分数表示。
| 地图表示 | 深度条件 | TL | SR | SPL |
|---|---|---|---|---|
| 拓扑图 | 不使用深度 | 12.59 | 70.25 | 61.29 |
| 拓扑图 + 深度特征 | 仿真真值 | 11.76 | 70.03 | 61.45 |
| 度量图 | 估计深度 | 14.41 | 60.64 | 52.17 |
| 度量图 | 仿真真值 | 14.15 | 60.90 | 52.80 |
| 混合地图 | 估计深度 | 13.61 | 74.67 | 63.63 |
| 混合地图 | 仿真真值 | 14.55 | 74.88 | 63.60 |
仅向拓扑表示增加深度特征,并没有带来明显的 SR 提升;混合地图的收益更符合“通过投影显式组织局部布局,并与拓扑结构互补”的解释。局部度量图单独使用时表现较弱,也说明覆盖附近细节不足以替代长程记忆。
估计深度与仿真真值下的混合地图结果接近,但这只能支持论文所用深度估计器和评测环境下的结论。它没有同时证明对任意深度噪声、位姿漂移或真实机器人传感器都保持相同效果。
此外,混合地图的 SR 高于纯拓扑图,TL 也更长。成功率、路线长度和 SPL 需要结合解读,不能仅据一个指标断言所有决策都更高效。
6.2 预训练任务的边际贡献
BEVBert Table 6 保持混合地图框架,逐步加入预训练目标,同样报告 R2R val-unseen:
| 预训练任务 | TL(m) | SR(%) | SPL(%) |
|---|---|---|---|
| 无上述预训练任务 | 15.56 | 60.24 | 48.29 |
| MLM | 16.26 | 73.52 | 60.13 |
| MLM + HSAP | 14.50 | 74.03 | 63.03 |
| MLM + HSAP + MSI | 14.55 | 74.88 | 63.60 |
MLM 带来明显的基础收益;加入 HSAP 后,SPL 从 60.13 提升至 63.03,动作相关监督改善了这一设置下的成功与路径效率综合表现。MSI 在已有两项任务上进一步提高 0.85 个百分点的 SR 和 0.57 个百分点的 SPL。
因此,全部预训练相对无预训练的收益不能全部归因于 MSI;地图结构、图文预训练、动作监督和语义补全各有作用。上述结果是作者报告的受控消融,不是本文复现结果,也没有提供足以判断微小差值统计显著性的重复实验信息。
6.3 DUET 的全局与局部消融
下表为 DUET Table 1 的 REVERIE val-unseen,保留导航和对象指认指标,单位均为百分数。
| 编码/融合设置 | OSR | SR | SPL | RGS | RGSPL |
|---|---|---|---|---|---|
| 仅细尺度 | 30.96 | 28.86 | 23.57 | 20.39 | 16.64 |
| 仅粗尺度 | 46.44 | 36.52 | 25.98 | — | — |
| 双尺度平均融合 | 51.86 | 45.81 | 31.94 | 32.49 | 22.78 |
| 双尺度动态融合 | 51.07 | 46.98 | 33.73 | 32.15 | 23.03 |
粗尺度的探索能力更强,但该消融没有局部对象预测头,不能产生 RGS;细尺度对终点和对象细节的判断更充分,却受局部动作范围限制。融合之后,两类信息共同支持探索和终止。动态融合相对平均融合增加 1.17 个 SR 百分点、1.79 个 SPL 百分点,但 OSR 和 RGS 没有同时提高,不能概括为所有指标一致提升。
DUET 这张表使用 REVERIE;前面的 BEVBert 两张表使用 R2R。它们各自说明模块贡献,不能将两个任务上的 SR 直接排序。
6.4 从专家路径到交互中的目标监督
地图不断增长,同一回合的候选集合也会改变。仅在专家路线前缀上训练,不一定覆盖策略回退或走偏后的地图状态。DUET 因而在预训练后加入伪交互示范者 PID。DUET,§3.3。
对非终止状态,将示范者的目标选择写作:
是训练环境图上的最短路径距离, 为任务目标。该准则同时考虑到候选的成本与候选到目标的剩余成本;到达目标时应监督 STOP。公式需要合法候选与终止条件配套,不能对空候选集合直接求最小值。
PID 可以使用训练环境的完整图和目标信息提供标签,而策略只根据当前指令、观测和已构建地图决策。两者的信息权限不同。训练损失为:
是策略实际访问的路径, 约束专家路径上的动作, 用于有对象指认监督的任务。PID 仍然给出动作标签;用策略采样轨迹,并不等于以奖励优化强化学习目标。
6.5 候选索引与回溯的实践检查
把双尺度方法接到导航环境时,最容易出错的环节是“两个数组是否指向同一个位置”。可围绕第三章的三个候选构造最小教学检查,按节点 ID建立映射,再计算分数。
| 数据或操作 | 应检查的条件 | 出错后的表现 |
|---|---|---|
| 全景视图索引 | 图像方向与视角编码对应 | 左右词和动作方向错位 |
| 局部候选节点 ID | 当前环境邻居与特征行对应 | 选择正确分数却走向另一节点 |
| 全局节点 ID | 重复观察更新同一节点 | 一个位置出现多个冲突副本 |
| 局部到全局映射 | 按 ID 对齐,不按数组行号相加 | 分数融合没有语义对应 |
| 已访问掩码 | 保留路由节点,屏蔽相应探索目标 | 无法回溯,或反复选择旧目标 |
| 远端目标执行 | 记录沿图经过的完整路径 | TL、SPL 与实际移动不一致 |
| STOP/对象预测 | 独立终止 token 与最终位置一致 | 在错误位置读取对象候选 |
验证时,可在保持节点与分数对应的前提下打乱候选数组顺序;最终选择的节点应保持不变。这个检查验证的是动作映射,不构成对完整 DUET 模型的性能复现。
DUET 与 BEVBert 的共同点是利用已观察空间结构作长程决策,关键差异在局部表示及其与全局候选的连接方式:DUET 保留当前视图/对象,并为远端候选汇总回溯支持;BEVBert 把多次 RGB-D 观察投到局部度量图,对覆盖内候选融合,对覆盖外候选保留拓扑分数。理解这些信息与动作的对应关系,才能判断一项改进改变了记忆、几何组织,还是目标选择机制。
下一篇转向大模型驱动的 VLN,讨论文本规划和视频模型如何接入这些导航决策接口。
参考资料
- Shizhe Chen, Pierre-Louis Guhur, Makarand Tapaswi, Cordelia Schmid, Ivan Laptev. Think Global, Act Local: Dual-scale Graph Transformer for Vision-and-Language Navigation. CVPR 2022,§3、Table 1、Figure 4。
- Dong An, Yuankai Qi, Yangguang Li, Yan Huang, Liang Wang, Tieniu Tan, Jing Shao. BEVBert: Multimodal Map Pre-training for Language-guided Navigation. ICCV 2023,地图构造、HSAP/MSI、微调及 Tables 5–6。
文中论文原图的权利及使用条件归原作者与相应权利人,第三方图片不纳入本站原创内容的许可声明。